Рубрика: DevOps и CI/CD

Инструменты автоматизации сборки, тестирования и развёртывания: конвейеры, контейнеризация, оркестрация.

Docker и Kubernetes: когда достаточно контейнеров, а когда нужна оркестрация

Контейнеры решают задачу упаковки и запуска приложения в предсказуемой среде, а Kubernetes нужен тогда, когда управление контейнерами превращается в отдельную операционную проблему. Если у вас один-два сервиса, понятная инфраструктура и нет жестких требований к масштабированию, Docker часто закрывает задачу без лишней сложности; если же сервисов много, нужен отказоустойчивый кластер, автоматическое масштабирование и управляемые обновления, без […]
Читать разбор

GitLab CI, GitHub Actions или Jenkins: выбор CI/CD-конвейера

Когда инженеры спрашивают, какой CI/CD выбрать, они редко ждут абстрактного рейтинга. За каждым таким вопросом стоит конкретная ситуация: команда из трёх человек на GitHub, enterprise с десятками legacy-сервисов или стартап, который хочет завтра выкатить первую версию. Мы в TSKLab не раз убеждались: универсального «лучшего» решения нет, зато есть чёткие критерии, которые помогают не ошибиться. В […]

Читать разбор

Организация DevOps-практик в небольшой инженерной лаборатории на примере TSKLab

# Организация DevOps-практик в небольшой инженерной лаборатории: как выстроить рабочий процесс на примере TSKLab

Когда команда одновременно пишет код, тестирует гипотезы на hardware, собирает стенды и выпускает обновления, без понятных правил быстро наступает хаос. Появляются ручные выкладки, «магические» скрипты, которые работают только на машине одного разработчика, и вечные вопросы: кто сломал сборку, где лежит нужная версия […]

Читать разбор

Как мы внедряли CI/CD: GitLab CI и GitHub Actions на проектах TSKLab

# Как мы внедряли CI/CD: GitLab CI и GitHub Actions на проектах TSKLab

В проектах TSKLab мы сознательно использовали два разных подхода к CI/CD: GitLab CI — там, где важны единая платформа и жесткий контроль пайплайнов, и GitHub Actions — там, где удобнее жить рядом с кодом и быстро масштабировать автоматизацию. Такой гибридный подход оказался практичнее, чем попытка […]

Читать разбор

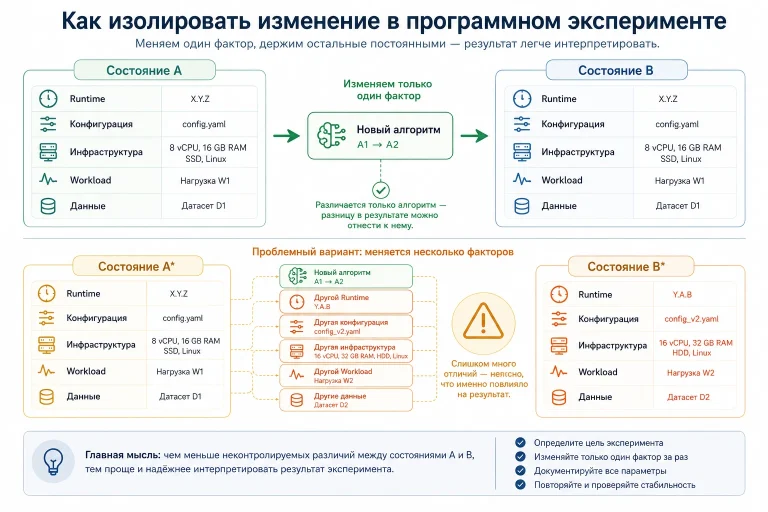
Как изолировать изменение в программном эксперименте: переменные, зависимости и конфаундеры

Представим, что после релиза сервис стал отвечать быстрее. В новой версии переписали кэширование, одновременно обновили runtime, изменили размер пула соединений и перенесли приложение на другой тип виртуальной машины. Само улучшение можно измерить. Гораздо труднее ответить, какое из четырёх изменений связано с ним сильнее.

Читать разбор

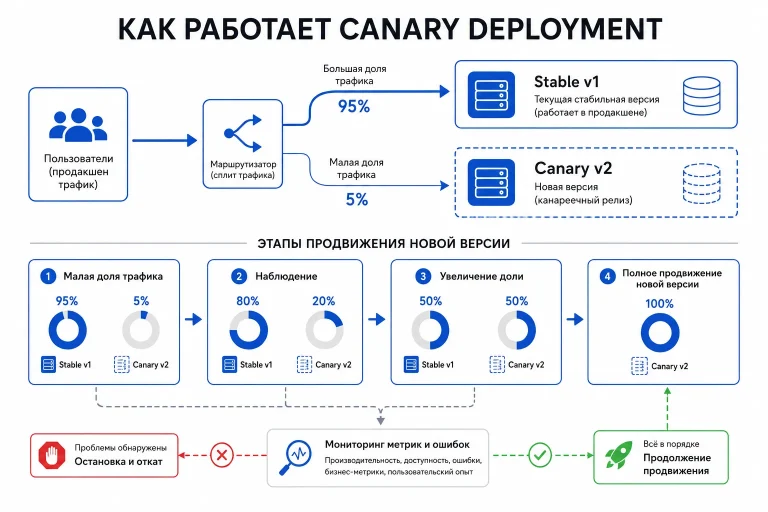
Canary deployment: как проверять новую версию на части трафика

После тестов новая версия приложения всё равно впервые сталкивается с реальным production-трафиком, реальными данными и рабочими зависимостями. Canary deployment уменьшает масштаб этого первого контакта: старая стабильная версия продолжает обслуживать основную нагрузку, а release candidate получает только ограниченную часть трафика.

Читать разбор

SEO как инженерный эксперимент: как отделять гипотезу, наблюдение и причинность

Разработчику привычно сначала сформулировать гипотезу, зафиксировать исходное состояние системы и только потом оценивать последствия изменения. Похожий подход используется и в SEO: например, в эксперименте с топовысок сначала сохраняют стартовые показатели целевой страницы, а затем сопоставляют их с новыми ссылочными событиями и дальнейшей динамикой.

Читать разбор

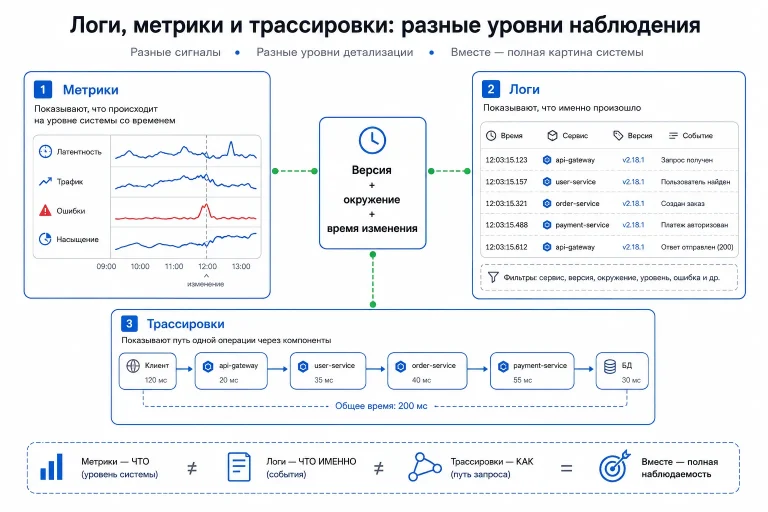
Логи, метрики и трассировки: что нужно видеть в системе до эксперимента

Observability часто начинают настраивать после проблемы: релиз уже выполнен, показатель изменился, и команда пытается понять, что произошло. Для инженерного эксперимента порядок лучше развернуть. Сначала нужно решить, какие состояния и события система умеет показывать, и только затем вносить изменение.

Читать разбор

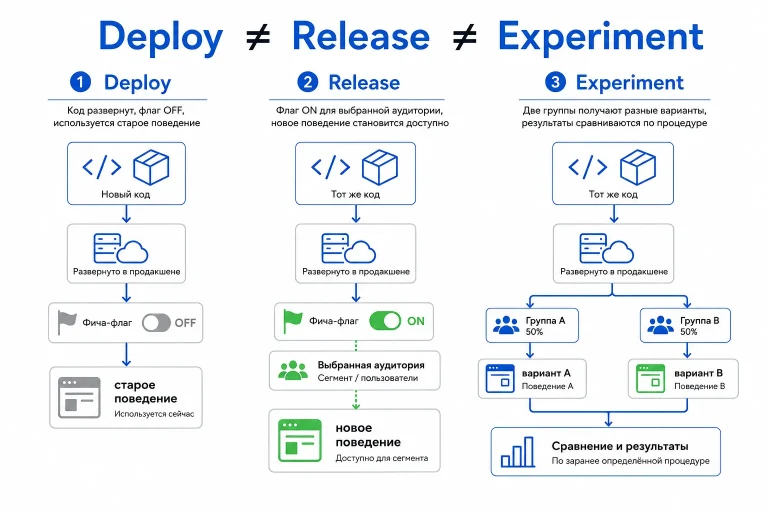
Feature flags: как отделить деплой кода от включения функции

Новая функция может уже находиться в production-коде и при этом оставаться недоступной пользователям. Для этого поведение приложения помещают за feature flag — условием, которое вычисляется во время выполнения и определяет, какую ветку логики использовать.

Читать разбор

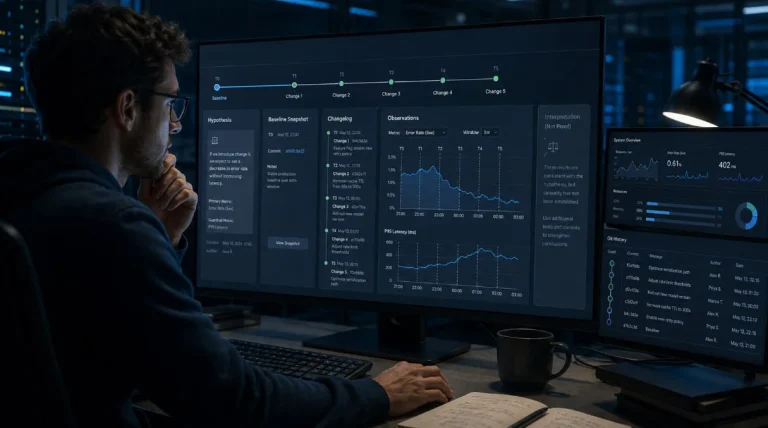
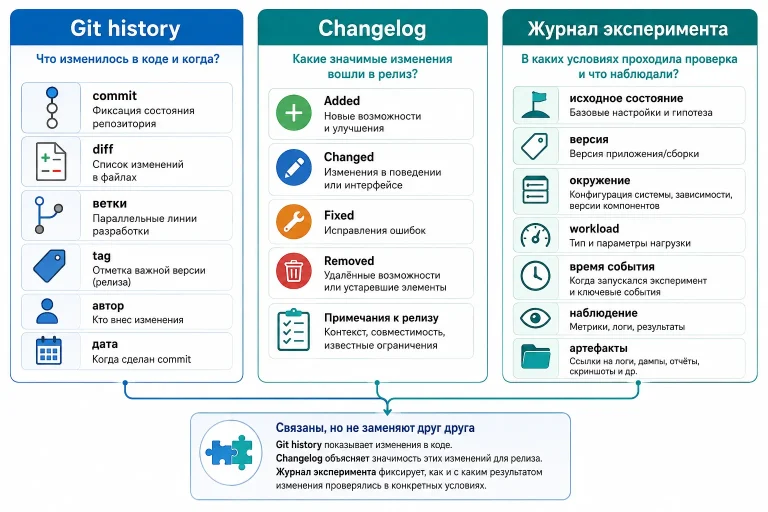
Git-история, changelog и журнал эксперимента: что именно фиксировать при изменениях

Когда после обновления поведение системы меняется, команде обычно нужно ответить сразу на несколько разных вопросов. Что было изменено в коде. Что вошло в релиз. Что именно происходило во время проверки и какие наблюдения были получены. Проблема в том, что эти три вопроса часто пытаются закрыть одним объектом, чаще всего списком commit.

Читать разбор